
ทำไมค่าเฉลี่ยจากคนแปลกหน้า 800 คน ถึงทายน้ำหนักวัวได้แม่นกว่าผู้เชี่ยวชาญคนเดียว
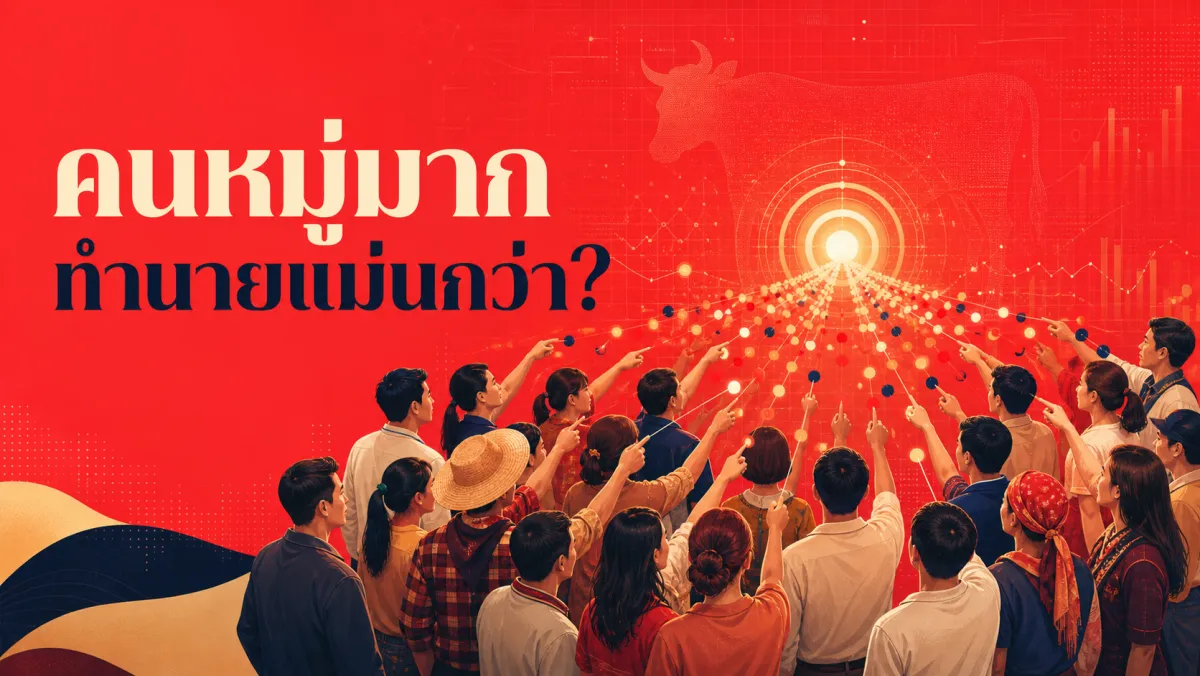
ลองนึกภาพงานประมูลปศุสัตว์ในชนบทอังกฤษเมื่อกว่าร้อยปีก่อน มีวัวอ้วนตัวหนึ่งถูกนำมาชั่งน้ำหนักหลังชำแหละ ผู้คนเกือบ 800 คนต่างเขียนตัวเลขทายน้ำหนักของมันลงบนตั๋วราคาถูก บางคนเป็นชาวนาหรือคนขายเนื้อที่มีความรู้เรื่องปศุสัตว์จริง แต่อีกจำนวนมากเป็นคนทั่วไปที่ทายเล่นๆ ตามความรู้สึกล้วนๆ นักสถิติชื่อดังที่บังเอิญผ่านมาเก็บตั๋วเหล่านั้นไปคำนวณ แล้วพบสิ่งที่เขาเองก็คาดไม่ถึง ค่ากลางของคำทายทั้งหมดนั้นแม่นยำกว่าที่ผู้เชี่ยวชาญด้านปศุสัตว์คนไหนจะทายได้ นี่คือจุดกำเนิดของแนวคิด "wisdom of crowds" หรือ "ปัญญาจากฝูงชน" ที่ทุกวันนี้ถูกนำไปใช้ตั้งแต่การพยากรณ์เศรษฐกิจ ตลาดหุ้น ไปจนถึงเหตุการณ์ภูมิรัฐศาสตร์ระดับโลก แต่คำถามที่น่าสนใจกว่าคือ ปัญญาจากฝูงชนนี้ทำงานได้จริงเสมอไปไหม และอะไรคือเงื่อนไขที่ทำให้มันพังทลายลงจนกลายเป็นแค่ "ฝูงชนที่คิดเหมือนกันหมด" แทนที่จะเป็นฝูงชนที่ฉลาดร่วมกัน
บรรณาธิการ
สรุปสั้น (Key Takeaways)
- Galton (1907, *Nature*) พบว่าค่ากลาง (median) ของคำทายน้ำหนักวัว 787 ใบจากงานประมูลปศุสัตว์ คลาดเคลื่อนจากน้ำหนักจริงเพียงไม่ถึง 1% แม้ผู้ทายแต่ละคนจะไม่ใช่ผู้เชี่ยวชาญเลยก็ตาม
- Mannes, Soll, & Larrick (2014, *Journal of Personality and Social Psychology*) วิเคราะห์ชุดข้อมูลจริง 90 ชุด พบว่า "select-crowd strategy" ซึ่งเฉลี่ยความเห็นจากคนที่มีความสามารถสูงสุดเพียง 5 คน ให้ผลแม่นยำและมั่นคงกว่าทั้งการเฉลี่ยทั้งกลุ่มและการเชื่อคนเก่งที่สุดเพียงคนเดียว
- Mellers และคณะ (2014, *Psychological Science*) จากโครงการ Good Judgment Project พบว่าการฝึกให้เหตุผลเชิงความน่าจะเป็น การรวมทีม และการติดตามผลงานผู้พยากรณ์ ช่วยเพิ่มความแม่นยำในการพยากรณ์เหตุการณ์ภูมิรัฐศาสตร์ได้จริง
- Almaatouq และคณะ (2020, *PNAS*) พบว่าเครือข่ายสังคมที่ปรับเปลี่ยนได้ (adaptive network) ลดความคลาดเคลื่อนของกลุ่มลงถึง 18-40% เมื่อเทียบกับเครือข่ายที่ตายตัว
- Keck & Tang (2020, *Psychological Science*) พบว่าการรวมคำตัดสินแบบ "สัญชาตญาณ" กับแบบ "วิเคราะห์เชิงระบบ" เข้าด้วยกัน ให้ผลแม่นยำกว่าการรวมคำตัดสินจากกระบวนการคิดแบบเดียวกันทั้งหมด
- Almaatouq, Rahimian, Burton, & Alhajri (2022, *Scientific Reports*) พบว่าอิทธิพลทางสังคมแบบรวมศูนย์ (centralized) อาจช่วยหรือทำลายปัญญาฝูงชนก็ได้ ขึ้นอยู่กับการกระจายตัวของคำทายเริ่มต้น
- Grossmann และคณะ "Forecasting Collaborative" (2023, *Nature Human Behaviour*) พบว่านักสังคมศาสตร์มืออาชีพพยากรณ์การเปลี่ยนแปลงทางสังคมได้ไม่แม่นยำกว่าค่าเฉลี่ยจากคนทั่วไปหรือแบบจำลองสถิติง่ายๆ เลย
- กรอบ อิสระ–เลือก–ผสม–ระวัง สังเคราะห์งานวิจัยทั้งเจ็ดชิ้นเป็นวิธีรวบรวมความเห็นกลุ่มให้แม่นยำ: เก็บความเห็นอิสระต่อกันก่อนเปิดเผยให้เห็นกัน เลือกเฉลี่ยจากคนผลงานดีแทนทุกคนหรือคนเดียว ผสมกระบวนการคิดแบบสัญชาตญาณกับวิเคราะห์ และระวังอิทธิพลทางสังคมแบบรวมศูนย์ที่ทำลายความเป็นอิสระ
จุดกำเนิด: วัวอ้วนหนึ่งตัว กับตั๋ว 787 ใบที่เปลี่ยนวิธีคิดเรื่องการทำนาย
Francis Galton นักสถิติและนักวิทยาศาสตร์ชาวอังกฤษ ตีพิมพ์บทความสั้นชื่อ "Vox Populi" (เสียงของประชาชน) ใน *Nature* ฉบับวันที่ 7 มีนาคม 1907 (เล่ม 75 หน้า 450-451) โดยเล่าถึงเหตุการณ์ที่งาน West of England Fat Stock and Poultry Exhibition ซึ่งมีการจัดประกวดทายน้ำหนักวัวอ้วนตัวหนึ่งหลังถูกชำแหละ ผู้เข้าร่วมซื้อตั๋วราคา 6 เพนนีเพื่อเขียนชื่อ ที่อยู่ และคำทายน้ำหนักของตัวเองลงไป มีผู้เข้าร่วมทั้งหมดราว 800 คน เป็นกลุ่มผสมระหว่างคนที่มีความรู้เรื่องปศุสัตว์จริง เช่น ชาวนาและคนขายเนื้อ กับคนทั่วไปที่ไม่มีความรู้เฉพาะทางเลยแต่เข้าร่วมเพราะความสนุกและการเดิมพัน Galton เองยอมรับว่าไม่สามารถระบุสัดส่วนที่แน่ชัดระหว่างสองกลุ่มนี้ได้ แต่สันนิษฐานว่าน่าจะมีคนที่ไม่ใช่ผู้เชี่ยวชาญปะปนอยู่จำนวนไม่น้อย เพราะจำนวนผู้เข้าร่วมที่มากถึงเกือบ 800 คนนั้นย่อมเกินกว่าจะเป็นผู้เชี่ยวชาญด้านปศุสัตว์ไปเสียทั้งหมดได้
Galton ขอยืมตั๋วทั้งหมดมาวิเคราะห์หลังการประกวดจบลง เขาคัดตั๋วที่อ่านไม่ออกหรือกรอกไม่สมบูรณ์ออกไป เหลือตั๋วที่ใช้ได้ 787 ใบ แล้วเรียงคำทายจากน้อยไปมากเพื่อหาค่ากลาง (median) ผลลัพธ์คือค่ากลางของคำทายทั้งหมดอยู่ที่ 1,207 ปอนด์ ในขณะที่น้ำหนักจริงของวัวหลังชำแหละอยู่ที่ 1,198 ปอนด์ คลาดเคลื่อนไปเพียง 9 ปอนด์ หรือน้อยกว่า 1% ของน้ำหนักจริง ทั้งที่คำทายแต่ละใบเองกระจายตัวกว้างมาก บางคนทายสูงเกินจริงมาก บางคนทายต่ำเกินจริงมาก แต่เมื่อนำมารวมกันแล้ว ความคลาดเคลื่อนของแต่ละคนกลับหักล้างกันไปเสียเป็นส่วนใหญ่ Galton สรุปว่าผลลัพธ์นี้ให้เครดิตกับความน่าเชื่อถือของกระบวนการตัดสินใจแบบประชาธิปไตยมากกว่าที่หลายคนคาดคิดไว้ก่อนหน้านั้น และบทความสั้นเพียงหน้าครึ่งชิ้นนี้เองที่กลายเป็นจุดเริ่มต้นของงานวิจัยเรื่อง wisdom of crowds ที่ต่อยอดกันมาอีกกว่าศตวรรษ
ไม่ใช่ทุกฝูงชนจะฉลาดเท่ากัน: กลยุทธ์ "เลือกก่อนเฉลี่ย"
คำถามที่ตามมาหลัง Galton คือ ถ้าอยากได้ปัญญาจากฝูงชนที่แม่นยำที่สุด ควรจะ "เฉลี่ยความเห็นทุกคน" หรือ "ฟังคนที่เก่งที่สุดเพียงคนเดียว" กันแน่ Albert E. Mannes, Jack B. Soll, และ Richard P. Larrick ตอบคำถามนี้ในงานชื่อ "The Wisdom of Select Crowds" ตีพิมพ์ใน *Journal of Personality and Social Psychology* ปี 2014 (เล่ม 107 ฉบับ 2 หน้า 276-299)
ทีมวิจัยใช้ทั้งการจำลองสถานการณ์ทางคณิตศาสตร์และการวิเคราะห์ชุดข้อมูลจริง 90 ชุดที่มีคนหลายคนทายค่าตัวเลขเดียวกัน (เช่น อัตราการว่างงาน ราคาสินค้า หรือผลการแข่งขัน) เพื่อเปรียบเทียบกลยุทธ์การรวมความเห็นหลายแบบ ผลลัพธ์คือ กลยุทธ์ที่พวกเขาเรียกว่า "select-crowd strategy" ซึ่งจัดอันดับผู้ทายตามตัวชี้วัดความสามารถบางอย่าง (เช่น ผลงานที่ผ่านมา) แล้วเฉลี่ยเฉพาะความเห็นของกลุ่มบนสุด เช่น 5 คนแรก ให้ผลลัพธ์ที่แม่นยำ มั่นคง และน่าเชื่อถือกว่าทั้งสองแบบสุดโต่ง คือการเฉลี่ยทุกคนในฝูงชน (ซึ่งเจือจางความแม่นยำด้วยคนที่ทายแย่) และการเชื่อคนที่ดูเก่งที่สุดเพียงคนเดียว (ซึ่งเสี่ยงมากถ้าเลือกผิดคน) งานวิจัยนี้ชี้ให้เห็นว่า "ปัญญาฝูงชน" ที่ดีที่สุดไม่ใช่แค่การรวมทุกเสียงเข้าด้วยกันแบบไม่เลือก แต่คือการหาจุดสมดุลระหว่างขนาดของกลุ่มกับคุณภาพของสมาชิกในกลุ่มนั้น
เมื่อรัฐบาลสหรัฐฯ ทดสอบว่าฝูงชนทำนายภูมิรัฐศาสตร์ได้แม่นแค่ไหน
ระหว่างปี 2011-2015 หน่วยงานวิจัยขั้นสูงด้านข่าวกรองของสหรัฐฯ (IARPA) ได้จัดการแข่งขันพยากรณ์เหตุการณ์ภูมิรัฐศาสตร์ระดับโลกครั้งใหญ่ โดยให้ทีมวิจัยจากมหาวิทยาลัยหลายทีมแข่งกันพยากรณ์คำถามหลายร้อยข้อ เช่น จะมีการเปลี่ยนแปลงผู้นำประเทศใดหรือไม่ ทีมที่ชนะคือ Good Judgment Project นำโดย Philip E. Tetlock และ Barbara A. Mellers จากมหาวิทยาลัย Pennsylvania ซึ่งตีพิมพ์ผลการวิเคราะห์ในงานชื่อ "Psychological Strategies for Winning a Geopolitical Forecasting Tournament" ใน *Psychological Science* ปี 2014 (เล่ม 25 ฉบับ 5 หน้า 1106-1115) โดยมีผู้ร่วมเขียนคือ Mellers, Ungar, Baron, Ramos, Gurcay, Fincher, Scott, Moore, Atanasov, Swift, Murray, Stone, และ Tetlock
ในช่วงสองปีแรกของการแข่งขัน ทีมนี้เริ่มต้นด้วยผู้พยากรณ์อาสาสมัครราว 1,600 คนที่ผ่านการคัดเลือกเบื้องต้น แล้วทดสอบกลไกทางจิตวิทยาสามอย่างว่าช่วยเพิ่มความแม่นยำได้จริงหรือไม่ ได้แก่ "training" คือการฝึกให้ผู้พยากรณ์เข้าใจอคติทางความคิดและใช้เทคนิคการให้เหตุผลเชิงความน่าจะเป็น เช่น การอ้างอิงกลุ่มเทียบเคียง (reference class) และการเฉลี่ยเมื่อมีการประมาณการหลายชุด "teaming" คือการให้ผู้พยากรณ์ทำงานเป็นทีมและถกเถียงเหตุผลเบื้องหลังความเชื่อของกันและกัน และ "tracking" คือการติดตามผลงานย้อนหลังเพื่อคัดเลือกผู้พยากรณ์ที่แม่นยำที่สุดมารวมกลุ่มพิเศษ (ซึ่งภายหลังถูกเรียกว่า "superforecasters")
ผลลัพธ์คือทั้งสามกลไกช่วยเพิ่มความแม่นยำได้จริง โดยการฝึกอบรมช่วยลดคะแนนความคลาดเคลื่อน (Brier score) ได้ราว 10% ตลอดช่วงการแข่งขัน และเมื่อรวมทุกกลไกเข้าด้วยกัน ทีม Good Judgment Project สามารถพยากรณ์แม่นยำกว่าทีมคู่แข่งอื่นๆ ในโครงการเดียวกันอย่างชัดเจน ถึงขนาดที่รายงานภายหลังระบุว่าความแม่นยำนั้นเทียบเท่าหรือดีกว่านักวิเคราะห์ข่าวกรองมืออาชีพที่เข้าถึงข้อมูลลับได้ งานวิจัยนี้จึงเป็นหลักฐานสำคัญที่แสดงว่าปัญญาฝูงชนไม่ได้เกิดขึ้นเองโดยอัตโนมัติ แต่ต้องอาศัยโครงสร้างและกระบวนการที่ถูกออกแบบมาอย่างตั้งใจ
เครือข่ายที่ "ปรับตัวได้" ทำให้ฝูงชนฉลาดขึ้นจริง
คำถามต่อมาคือ ถ้าคนในฝูงชนมองเห็นความเห็นของกันและกันได้ (ไม่ใช่ทายแยกกันแบบ Galton) จะยิ่งช่วยหรือยิ่งทำลายปัญญาฝูงชน Abdullah Almaatouq, Alejandro Noriega-Campero, Abdulrahman Alotaibi, P. M. Krafft, Mehdi Moussaid, และ Alex Pentland ตอบคำถามนี้ในงานชื่อ "Adaptive Social Networks Promote the Wisdom of Crowds" ตีพิมพ์ใน *Proceedings of the National Academy of Sciences (PNAS)* ปี 2020 (เล่ม 117 ฉบับ 21 หน้า 11379-11386)
ทีมวิจัยทำการทดลอง 2 ชุด รวมผู้เข้าร่วมทั้งหมด 1,421 คนผ่านแพลตฟอร์ม Amazon Mechanical Turk จัดกลุ่มละ 12 คน ให้ทำภารกิจประมาณค่าความสัมพันธ์ระหว่างตัวแปรในกราฟกระจาย (scatter plot) ต่อเนื่อง 20 รอบ โดยแต่ละคนมีคุณภาพสัญญาณข้อมูลต่างกัน หลังรอบที่ 10 นักวิจัยจะสลับคุณภาพสัญญาณของผู้เข้าร่วมใหม่แบบไม่บอกล่วงหน้าเพื่อจำลอง "การเปลี่ยนแปลงของสภาพแวดล้อมข้อมูล" กลุ่มหนึ่งถูกจัดให้อยู่ในเครือข่ายแบบตายตัว (แต่ละคนมีเพื่อนบ้านคงที่ 3 คนตลอดการทดลอง) ส่วนอีกกลุ่มอยู่ในเครือข่ายแบบปรับตัวได้ (แต่ละรอบสามารถเลือกเพื่อนบ้านใหม่ได้สูงสุด 3 คนตามผลงานที่ผ่านมา)
ผลลัพธ์คือ เครือข่ายแบบปรับตัวได้ลดความคลาดเคลื่อนของแต่ละบุคคลลง 17% โดยเฉลี่ย และลดลงถึง 36% ในช่วงที่กำลังปรับตัวหลังการเปลี่ยนแปลงสัญญาณ (p<10⁻⁵) ส่วนความคลาดเคลื่อนของกลุ่มโดยรวมลดลง 18% และลดลงถึง 40% ในช่วงปรับตัว แม้แต่ผู้เข้าร่วมที่ทำผลงานดีที่สุดในกลุ่มก็ยังได้ประโยชน์จากการมีปฏิสัมพันธ์กับกลุ่มเช่นกัน โดยลดความคลาดเคลื่อนลงราว 20-30% งานวิจัยนี้ชี้ว่าเครือข่ายสังคมที่ปรับโครงสร้างตามผลงานจริงของสมาชิกได้ ช่วยให้ฝูงชนฉลาดขึ้นกว่าการทายแยกกันแบบสมบูรณ์หรือเครือข่ายที่ตายตัว อย่างไรก็ตาม นักวิจัยเองก็ระบุว่านี่เป็นการทดลองในห้องปฏิบัติการที่ถูกทำให้ง่ายลง ผลลัพธ์จึงอาจไม่ครอบคลุมทุกเงื่อนไขในโลกจริงที่มีขนาดกลุ่ม ประเภทงาน และแรงจูงใจต่างกันออกไป
ผสมสัญชาตญาณกับการวิเคราะห์ ดีกว่าใช้แบบเดียวล้วนๆ
Steffen Keck และ Wenjie Tang ตั้งคำถามว่าความหลากหลายของ "กระบวนการคิด" ไม่ใช่แค่ความหลากหลายของความเห็น จะช่วยเพิ่มปัญญาฝูงชนได้ไหม ในงานชื่อ "Enhancing the Wisdom of the Crowd With Cognitive-Process Diversity: The Benefits of Aggregating Intuitive and Analytical Judgments" ตีพิมพ์ใน *Psychological Science* ปี 2020 (เล่ม 31 ฉบับ 10 หน้า 1272-1282)
การทดลองแบ่งเป็น 3 ชุด การทดลองที่ 1 (ผู้เข้าร่วม 152 คน) ให้ทายวันที่เกิดเหตุการณ์ประวัติศาสตร์ ภายใต้เงื่อนไขต่างกัน คือกลุ่ม "วิเคราะห์" (มีเวลาคิดไม่จำกัด ใช้เหตุผลอย่างเป็นระบบ) กลุ่ม "สัญชาตญาณ" (มีเวลาตอบเพียง 7 วินาที ใช้ความรู้สึกแรก) และกลุ่มควบคุม การทดลองที่ 2 (ผู้เข้าร่วม 98 คน) ให้ทายผลการแข่งขันฟุตบอลโลกเป็นค่าความน่าจะเป็น เทียบกับราคาต่อรองของสำนักพนัน และการทดลองที่ 3 (ผู้เข้าร่วม 3,695 คน) ให้ทายน้ำหนักคนจากภาพถ่าย โดยแต่ละคนให้คำตอบเพียงหนึ่งครั้งเพื่อให้แน่ใจว่าความเห็นเป็นอิสระจากกันจริงๆ
ผลลัพธ์คือ ฝูงชนที่รวมทั้งคนที่ใช้กระบวนการคิดแบบสัญชาตญาณและแบบวิเคราะห์เข้าด้วยกัน ให้ผลแม่นยำกว่าฝูงชนที่ใช้กระบวนการคิดแบบเดียวกันทั้งหมดอย่างสม่ำเสมอในทุกการทดลอง และยิ่งขนาดฝูงชนใหญ่ขึ้น ข้อได้เปรียบนี้ก็ยิ่งชัดเจนขึ้น เหตุผลเบื้องหลังคือ ความคลาดเคลื่อนของคนกลุ่มวิเคราะห์กับกลุ่มสัญชาตญาณมีความสัมพันธ์กันต่ำมาก (r = -0.03 ในการทดลองที่ 1 และ r = 0.41 ในการทดลองที่ 2) ต่ำกว่าความสัมพันธ์ของความคลาดเคลื่อนภายในกลุ่มเดียวกันเอง ซึ่งหมายความว่าความผิดพลาดของสองกลุ่มนี้มักไปคนละทิศทาง จึงหักล้างกันได้ดีกว่าเวลานำมารวมกัน นักวิจัยเองก็ตั้งข้อสังเกตว่าการทดลองนี้บังคับให้ผู้เข้าร่วมใช้กระบวนการคิดแบบใดแบบหนึ่งอย่างชัดเจน ในขณะที่การตัดสินใจจริงในชีวิตมักผสมทั้งสองแบบเข้าด้วยกันอยู่แล้ว และยังไม่มีหลักฐานตรงเรื่องกลไกทางประสาทหรือความคิดที่อยู่เบื้องหลังความแตกต่างนี้
เมื่อไหร่ที่อิทธิพลทางสังคมทำลายปัญญาฝูงชนแทนที่จะเสริม
ทีมวิจัยชุดเดิมนำโดย Abdullah Almaatouq กลับมาตอบคำถามที่ซับซ้อนขึ้นไปอีกขั้น คือ อิทธิพลทางสังคมจะช่วยหรือทำลายปัญญาฝูงชน ขึ้นอยู่กับอะไรกันแน่ ในงานชื่อ "The Distribution of Initial Estimates Moderates the Effect of Social Influence on the Wisdom of the Crowd" ร่วมกับ M. Amin Rahimian, Jason W. Burton, และ Abdulla Alhajri ตีพิมพ์ใน *Scientific Reports* ปี 2022 (เล่ม 12 บทความหมายเลข 16546)
งานวิจัยนี้ใช้ทั้งการวิเคราะห์เชิงทฤษฎี การจำลองเชิงตัวเลข และการวิเคราะห์ซ้ำจากชุดข้อมูลการทดลองจริง 4 ชุด รวมผู้เข้าร่วม 2,885 คน แบ่งเป็น 99 กลุ่ม ทำภารกิจประมาณค่า 54 งาน ได้คำตอบระดับบุคคล 15,562 ชุด และคำตอบระดับกลุ่ม 687 ชุด
ผลลัพธ์คือ ปัญญาฝูงชนขึ้นอยู่กับปฏิสัมพันธ์ระหว่างสองปัจจัย คือระดับการรวมศูนย์ของเครือข่ายอิทธิพลทางสังคม (ว่าบางคนมีอิทธิพลเหนือคนอื่นมากน้อยแค่ไหน) กับลักษณะการกระจายตัวของคำทายเริ่มต้น เมื่อคำทายเริ่มต้นมีการกระจายตัวแบบ "หางหนัก" (heavy-tailed ซึ่งพบได้บ่อยในงานประมาณค่าจริง) เครือข่ายแบบรวมศูนย์ที่บางคนมีอิทธิพลเหนือคนอื่นกลับช่วยเพิ่มความแม่นยำของกลุ่ม แต่เมื่อคำทายเริ่มต้นกระจายตัวใกล้เคียงค่าจริงแบบปกติ เครือข่ายแบบกระจายอำนาจกลับให้ผลดีกว่า นักวิจัยพัฒนาตัวชี้วัดที่เรียกว่า R เพื่อทำนายว่าโครงสร้างเครือข่ายแบบไหนจะเหมาะกับสถานการณ์ไหน
งานวิจัยนี้จึงตอบคำถามสำคัญว่า "อิทธิพลทางสังคมทำลายปัญญาฝูงชนเสมอไปหรือไม่" ด้วยคำตอบที่ละเอียดกว่าเดิมว่า "ขึ้นอยู่กับเงื่อนไข" ไม่ใช่คำตอบที่ตายตัวแบบใดแบบหนึ่ง ข้อจำกัดที่นักวิจัยระบุไว้คือกรอบแนวคิดนี้ใช้ได้เฉพาะกับงานประมาณค่าตัวเลขที่มีค่าจริงเป็นบวกและมีคำตอบที่ถูกต้องตายตัวเท่านั้น และการคำนวณตัวชี้วัด R ต้องมีข้อมูลคำทายเริ่มต้นอยู่แล้ว ซึ่งในทางปฏิบัติอาจต้องใช้ข้อมูลย้อนหลังมาช่วยประมาณการแทน
แม้แต่นักวิชาการมืออาชีพก็ทำนายสังคมได้ไม่แม่นกว่าฝูงชนทั่วไป
คำถามสุดท้ายที่ท้าทายที่สุดคือ ผู้เชี่ยวชาญที่ศึกษาสังคมมาทั้งชีวิตจะพยากรณ์การเปลี่ยนแปลงทางสังคมได้แม่นยำกว่าฝูงชนทั่วไปหรือไม่ กลุ่มนักวิจัยนานาชาติที่รวมตัวกันในชื่อ "Forecasting Collaborative" นำโดย Igor Grossmann, Amanda Rotella, Cendri A. Hutcherson, Konstantyn Sharpinskyi, Michael E. W. Varnum และผู้ร่วมเขียนอีกจำนวนมาก (รวมทั้งหมด 139 คน) ตีพิมพ์งานชื่อ "Insights Into the Accuracy of Social Scientists' Forecasts of Societal Change" ใน *Nature Human Behaviour* ปี 2023 (เล่ม 7 ฉบับ 4 หน้า 484-501)
ทีมวิจัยจัดการแข่งขันพยากรณ์ทั้งหมด 2 ครั้ง โดยให้นักสังคมศาสตร์ส่งคำพยากรณ์ล่วงหน้าแบบลงทะเบียนไว้ก่อน (pre-registered) เกี่ยวกับการเปลี่ยนแปลงทางสังคมในหัวข้อที่สาขาสังคมศาสตร์ศึกษาเป็นประจำ เช่น แนวโน้มอุดมการณ์ทางการเมือง ความแบ่งขั้วทางการเมือง ความพึงพอใจในชีวิต อารมณ์ความรู้สึกบนโซเชียลมีเดีย และอคติทางเพศ/เชื้อชาติในที่ทำงาน โดยเก็บข้อมูลตลอดช่วงปีแรกของการระบาดใหญ่ COVID-19 การแข่งขันครั้งที่ 1 มีทีมนักสังคมศาสตร์เข้าร่วม 86 ทีม ส่งคำพยากรณ์รวม 359 ชุด เทียบกับกลุ่มตัวอย่างประชาชนทั่วไปกว่า 800 คน ส่วนการแข่งขันครั้งที่ 2 มีทีมเข้าร่วมเพิ่มเป็น 120 ทีม ส่งคำพยากรณ์ 546 ชุด ผลลัพธ์คือ โดยเฉลี่ยแล้วคำพยากรณ์ของนักสังคมศาสตร์มืออาชีพไม่ได้แม่นยำกว่าคำพยากรณ์ของแบบจำลองสถิติง่ายๆ (เช่น ค่าเฉลี่ยในอดีตหรือการถดถอยเชิงเส้น) หรือค่าเฉลี่ยจากกลุ่มตัวอย่างประชาชนทั่วไปเลย ข้อได้เปรียบเล็กน้อยที่พบมีเพียงในทีมที่นำข้อมูลย้อนหลังมาพิจารณาประกอบ และทีมที่รวมผู้เชี่ยวชาญจากหลายสาขาเข้าด้วยกันเท่านั้น นักวิจัยย้ำว่าผลลัพธ์นี้ไม่ได้แปลว่าความเชี่ยวชาญไร้ค่า แต่ชี้ว่าการอธิบายปรากฏการณ์ที่เกิดขึ้นแล้ว กับการพยากรณ์สิ่งที่ยังไม่เกิดขึ้น เป็นทักษะคนละแบบกัน และเตือนไม่ให้นักวิชาการอ้างความมั่นใจเกินจริงในการพยากรณ์อนาคตทางสังคม
กรอบอิสระ–เลือก–ผสม–ระวัง
เพื่อแปลงงานวิจัยทั้งเจ็ดชิ้นเป็นวิธีรวบรวมความเห็นกลุ่มให้แม่นยำขึ้น เราสังเคราะห์เป็นกรอบ อิสระ–เลือก–ผสม–ระวัง กรอบนี้เป็นเครื่องมือประยุกต์ของบทความ ไม่ใช่วิธีการพยากรณ์ที่ผ่านการรับรองทางสถิติแยกต่างหาก
1. อิสระ — เก็บความเห็นอิสระต่อกันก่อนเปิดเผยให้เห็นกัน
ตามที่ Galton (1907) พบ ความคลาดเคลื่อนของแต่ละคนหักล้างกันได้ก็ต่อเมื่อความเห็นแต่ละคนเป็นอิสระจากกันจริงๆ ให้ทุกคนในทีมประมาณค่าด้วยตัวเองก่อน แล้วค่อยเปิดเผยและถกเถียงกันทีหลัง ไม่ใช่ให้เห็นความเห็นคนอื่นก่อนตัดสินใจ
2. เลือก — เลือกเฉลี่ยจากคนผลงานดี แทนทุกคนหรือคนเดียว
ตามกลยุทธ์ "select-crowd" ของ Mannes, Soll, & Larrick (2014) การเฉลี่ยความเห็นจากคนที่มีผลงานดีที่สุดกลุ่มเล็กๆ มักให้ผลมั่นคงกว่าทั้งการเฉลี่ยทุกคนแบบไม่กรอง และการเชื่อคนเก่งที่สุดเพียงคนเดียว
3. ผสม — ผสมกระบวนการคิดแบบสัญชาตญาณกับวิเคราะห์
ตามที่ Keck & Tang (2020) พบว่าความหลากหลายของกระบวนการคิด ไม่ใช่แค่ความหลากหลายของภูมิหลัง ช่วยเพิ่มความแม่นยำของกลุ่มได้ชัดเจน ให้มีทั้งคนที่ตอบเร็วตามสัญชาตญาณและคนที่คิดช้าแบบวิเคราะห์อยู่ในทีมเดียวกัน
4. ระวัง — ระวังอิทธิพลทางสังคมแบบรวมศูนย์ที่ทำลายความเป็นอิสระ
ตามที่ Almaatouq, Rahimian, Burton, & Alhajri (2022) พบว่าอิทธิพลทางสังคมแบบรวมศูนย์อาจช่วยหรือทำลายความแม่นยำของกลุ่มก็ได้ ให้ระวังเป็นพิเศษเมื่อมีคนหนึ่งพูดเสียงดังหรือมีอำนาจเหนือคนอื่นในทีม เพราะอาจทำให้ความเห็นไหลไปทิศทางเดียวกันหมดโดยไม่ได้มาจากการวิเคราะห์จริง
กรณีจำลอง: ทีมโปรเจกต์ที่ประมาณระยะเวลางานผิดพลาดซ้ำๆ
สมมติว่า "คุณกวาง" เป็นผู้จัดการโปรเจกต์ซอฟต์แวร์ ทุกครั้งที่ต้องประมาณระยะเวลาทำงานให้ลูกค้า เธอมักถามความเห็นในที่ประชุมทีมแบบเปิดเผย ซึ่งมักจบลงที่ทุกคนเห็นด้วยกับตัวเลขที่หัวหน้าทีมเทคนิคพูดออกมาก่อน ทั้งที่โปรเจกต์ก่อนๆ มักเสร็จช้ากว่าที่ประมาณไว้เกือบทุกครั้ง
คุณกวางลองปรับกระบวนการตามกรอบนี้ในโปรเจกต์ถัดไป: อิสระ เธอให้สมาชิกทีมทุกคนเขียนตัวเลขประมาณการระยะเวลาลงในฟอร์มแยกกันก่อน โดยยังไม่เห็นตัวเลขของคนอื่น, เลือก เธอดูประวัติความแม่นยำของแต่ละคนจากโปรเจกต์ก่อนหน้า แล้วให้น้ำหนักกับตัวเลขของสามคนที่เคยประมาณแม่นที่สุดมากกว่าคนอื่น แทนเฉลี่ยทุกคนเท่ากันหมด, ผสม เธอขอทั้งตัวเลขที่ตอบทันที (สัญชาตญาณจากประสบการณ์) และตัวเลขที่คำนวณจากการแตกงานย่อยอย่างละเอียด (การวิเคราะห์) แล้วนำทั้งสองแบบมาพิจารณาร่วมกัน และ ระวัง เมื่อหัวหน้าทีมเทคนิคเริ่มพูดตัวเลขของตัวเองในที่ประชุม เธอเตือนให้ทุกคนดูตัวเลขที่เขียนไว้ก่อนหน้าของตัวเองก่อน แทนเปลี่ยนใจตามเสียงที่ดังที่สุดในห้อง
โปรเจกต์ถัดมาที่ใช้กระบวนการนี้ ประมาณการระยะเวลาใกล้เคียงกับความเป็นจริงมากกว่าโปรเจกต์ก่อนหน้าอย่างเห็นได้ชัด กรณีนี้เป็น สถานการณ์จำลองเพื่อสาธิตวิธีคิด ไม่ใช่ทีมงานหรือโปรเจกต์จริง
ลองเอาไปปรับใช้ดู
1. ลองเก็บรวบรวมความเห็นจากคนหลายคนแบบอิสระต่อกันก่อนตัดสินใจสำคัญดูครับ ตามที่ Galton (1907) และ Mannes, Soll, & Larrick (2014) พบ ค่าเฉลี่ยหรือค่ากลางจากความเห็นอิสระหลายคนมักแม่นยำกว่าความเห็นของคนคนเดียว แม้แต่ผู้เชี่ยวชาญก็ตาม 2. ถ้าต้องเลือกกลุ่มคนมาให้ความเห็น ลองไม่เลือกทุกคนแบบไม่กรอง แต่ก็ไม่เชื่อคนเก่งที่สุดเพียงคนเดียวดูนะครับ ตามกลยุทธ์ "select-crowd" ของ Mannes, Soll, & Larrick (2014) การเฉลี่ยความเห็นจากคนที่มีผลงานดีที่สุดกลุ่มเล็กๆ (เช่น 5 คน) มักให้ผลมั่นคงกว่าทั้งสองแบบสุดโต่ง 3. ลองฝึกทีมให้เข้าใจอคติทางความคิดและถกเถียงเหตุผลกันอย่างเปิดเผยดูไหมครับ แทนที่จะแค่ลงคะแนนเงียบๆ ตามที่ Mellers และคณะ (2014) พบว่า training และ teaming ช่วยเพิ่มความแม่นยำในการพยากรณ์ได้จริง ไม่ใช่แค่การรวมคนเก่งไว้ด้วยกันเฉยๆ 4. ลองผสมคนที่คิดเร็วตามสัญชาตญาณกับคนที่คิดช้าแบบวิเคราะห์เข้าไว้ในทีมเดียวกันดูครับ ตามที่ Keck & Tang (2020) พบว่าความหลากหลายของกระบวนการคิด ไม่ใช่แค่ความหลากหลายของภูมิหลัง ช่วยเพิ่มความแม่นยำของกลุ่มได้อย่างชัดเจน 5. น่าจะระวังสถานการณ์ที่คนในกลุ่มเห็นความเห็นของกันและกันก่อนตัดสินใจ โดยเฉพาะถ้ามีคนหนึ่งพูดเสียงดังหรือมีอำนาจเหนือคนอื่น ตามที่ Almaatouq, Rahimian, Burton, & Alhajri (2022) พบว่าอิทธิพลทางสังคมแบบรวมศูนย์อาจช่วยหรือทำลายความแม่นยำของกลุ่มก็ได้ ขึ้นอยู่กับว่าความเห็นเริ่มต้นของกลุ่มกระจายตัวแบบไหน 6. ไม่ควรวางใจว่าความเชี่ยวชาญเฉพาะทางจะแปลงเป็นความสามารถในการพยากรณ์อนาคตได้เสมอไป ตามที่ Grossmann และคณะ (2023) พบว่านักสังคมศาสตร์มืออาชีพพยากรณ์การเปลี่ยนแปลงทางสังคมได้ไม่แม่นกว่าฝูงชนทั่วไปเลย การรวมความเห็นจากคนหลากหลายจึงยังคุ้มค่าแม้จะมีผู้เชี่ยวชาญอยู่ในกลุ่มแล้วก็ตาม
คำถามที่พบบ่อย
- ทำไมค่าเฉลี่ยจากคนธรรมดาถึงแม่นยำกว่าผู้เชี่ยวชาญคนเดียวได้ ทั้งที่แต่ละคนอาจทายผิดมาก?
- กลไกสำคัญคือความคลาดเคลื่อนของแต่ละคนมักไปคนละทิศทาง ตามที่ Galton (1907) พบว่าคนที่ทายสูงเกินจริงกับคนที่ทายต่ำเกินจริงจะหักล้างกันเมื่อนำมาเฉลี่ยหรือหาค่ากลาง ทำให้ความคลาดเคลื่อนที่เหลืออยู่ในค่าเฉลี่ยน้อยกว่าความคลาดเคลื่อนเฉลี่ยของแต่ละคน แต่เงื่อนไขสำคัญคือความเห็นแต่ละคนต้องเป็นอิสระจากกันจริงๆ ไม่ใช่ลอกหรือได้รับอิทธิพลจากคนอื่นมาก่อน
- ถ้าอย่างนั้นทำไมบางครั้งฝูงชนถึงตัดสินใจผิดพลาดร่วมกันทั้งกลุ่ม เช่น ฟองสบู่ในตลาดหุ้น?
- เพราะเงื่อนไข "ความเป็นอิสระ" ของความเห็นถูกทำลายไป ตามที่ Almaatouq, Rahimian, Burton, & Alhajri (2022) พบว่าเมื่อคนในกลุ่มเห็นความเห็นของกันและกันและมีบางคนมีอิทธิพลเหนือคนอื่นมาก ความเห็นของกลุ่มอาจไหลไปทิศทางเดียวกันหมด (herding) จนกลายเป็น "ฝูงชนที่คิดเหมือนกัน" แทนที่จะเป็น "ฝูงชนที่ฉลาดร่วมกัน" ซึ่งเป็นคนละเรื่องกัน แม้ผลลัพธ์จะไม่ได้เลวร้ายเสมอไปในทุกกรณีก็ตาม
- การรวมทีมคนหลายคนแบบไหนถึงจะได้ปัญญาฝูงชนที่ดีที่สุด?
- ตามหลักฐานจาก Mannes, Soll, & Larrick (2014), Mellers และคณะ (2014), และ Keck & Tang (2020) ควรมีอย่างน้อยสามองค์ประกอบ คือความเห็นที่เป็นอิสระต่อกันในตอนเริ่มต้น ความหลากหลายของกระบวนการคิด (ไม่ใช่แค่ความหลากหลายของภูมิหลัง) และกระบวนการติดตามผลงานเพื่อให้น้ำหนักกับคนที่ผลงานดีมากกว่าคนที่ผลงานแย่ ไม่ใช่การเฉลี่ยทุกคนเท่ากันหมดโดยไม่แยกแยะ
- ถ้าอย่างนั้นผู้เชี่ยวชาญไม่มีประโยชน์อะไรเลยหรือ?
- ไม่ใช่เช่นนั้น ตามที่ Grossmann และคณะ (2023) เตือนไว้ ผลการศึกษาชี้เฉพาะเรื่อง "การพยากรณ์อนาคตที่ยังไม่เกิดขึ้น" เท่านั้นว่าความเชี่ยวชาญไม่ได้รับประกันความแม่นยำเสมอไป แต่ความเชี่ยวชาญยังมีค่าอย่างมากในการอธิบายว่าทำไมสิ่งต่างๆ ถึงเกิดขึ้นแล้ว ข้อสรุปที่เหมาะสมกว่าคือควรใช้ทั้งความเชี่ยวชาญและปัญญาฝูงชนประกอบกัน แทนที่จะเลือกใช้อย่างใดอย่างหนึ่งเพียงอย่างเดียว
แหล่งอ้างอิง
บทความที่เกี่ยวข้อง
AI คัดเรซูเม่ "เป็นกลาง" กว่ามนุษย์จริงไหม งานวิจัยใหม่พบคนทำตามคำแนะนำอคติของ AI ถึง 90% และระบบเดียวกันกีดกันผู้สมัครผิวดำเกิน 1 ใน 4 ซ้ำในหลายบริษัท
งานวิจัยจากใบสมัครงานจริงกว่า 4 ล้านใบพบว่าระบบ AI คัดกรองที่หลายบริษัทใช้ร่วมกันกีดกันผู้สมัครผิวดำเกิน 1 ใน 4 อย่างเป็นระบบ และเมื่อทดสอบกับ LLM 5 ตัว ก็ยังพบความลำเอียงทางเชื้อชาติชัดเจนแม้ผู้หญิงจะได้คะแนนดีกว่าผู้ชายโดยรวม
รวมคนกับ AI เข้าด้วยกัน แล้วตัดสินใจแม่นขึ้นจริงไหม งานวิเคราะห์ 106 การทดลองพบทีมผสมมักแพ้ผู้เล่นเดี่ยวที่เก่งที่สุด และแพทย์ที่ใช้ AI ช่วยวินิจฉัยยังทำได้แค่ 76% ขณะที่ AI เดี่ยวทำได้ถึง 92%
งานวิเคราะห์ 106 การทดลองพบว่าโดยเฉลี่ยทีมผสมมนุษย์+AI แพ้ผู้เล่นเดี่ยวที่เก่งที่สุด และในการทดลองจริงกับแพทย์ 50 คน กลุ่มที่ใช้ AI ช่วยวินิจฉัยยังทำได้แค่ 76% ขณะที่ AI ทำงานคนเดียวกลับได้ถึง 92% เพราะมนุษย์มักถ่วงน้ำหนักคำแนะนำ AI ต่ำเกินไป
อัลกอริทึมเป็นหัวหน้าคุณหรือยัง: บริษัทในสหรัฐฯ 90% ใช้ AI สั่งงาน-ติดตาม-ประเมินพนักงานแล้ว งานวิจัยชี้ผลกระทบต่อใจคนทำงานจริง
งานสำรวจคนทำงานกว่า 1,000 คนในเยอรมนีพบว่าการถูกจัดการด้วยอัลกอริทึมเพิ่มความเร่งรีบในการทำงาน ลดความเป็นอิสระ และเพิ่มความเครียดทางใจโดยตรง ขณะที่งานวิจัยในไรเดอร์จีนก็พบว่าการรับรู้ถึงการควบคุมแบบนี้นำไปสู่พฤติกรรมเบี่ยงเบนทั้งในที่ทำงานและที่บ้าน
ทีมที่หลากหลายสร้างนวัตกรรมได้ดีกว่าจริงไหม งานวิจัยระดับโลกบอกว่าคำตอบซับซ้อนกว่าสโลแกนขององค์กร
"ความหลากหลายคือกุญแจสู่นวัตกรรม" เป็นประโยคที่ปรากฏในรายงานที่ปรึกษาธุรกิจ สไลด์นำเสนอผู้บริหาร และนโยบายการจ้างงานของบริษัททั่วโลกมานานกว่าทศวรรษ แต่ถ้าถามตรงๆ ว่ามีหลักฐานทางวิทยาศาสตร์ที่หนักแน่นแค่ไหนรองรับคำกล่าวนี้ คำตอบกลับไม่ตรงไปตรงมาอย่างที่สโลแกนบอก นักวิจัยที่วิเคราะห์ข้อมูลสิทธิบัตร งานวิจัยวิทยาศาสตร์นับล้านชิ้น และการทดลองในห้องแล็บนับพันทีม พบทั้งหลักฐานที่สนับสนุนอย่างชัดเจนว่าทีมที่หลากหลายผลิตผลงานที่แปลกใหม่และมีผลกระทบสูงกว่าจริง ไปพร้อมกับหลักฐานที่เตือนว่าความหลากหลายบางประเภทกลับไม่ช่วยหรือถึงขั้นเป็นอุปสรรค และคนที่สร้างนวัตกรรมจากความหลากหลายนั้นอาจไม่ได้รับผลตอบแทนทางอาชีพที่คู่ควรด้วยซ้ำ บทความนี้จะพาไปดูงานวิจัยสำคัญที่สุดในรอบไม่กี่ปีที่ผ่านมาทั้งฝั่งที่สนับสนุนและฝั่งที่ตั้งคำถาม เพื่อให้เห็นภาพที่ใกล้เคียงความจริงมากที่สุด ไม่ใช่แค่คำตอบที่ฟังดูดีสำหรับนโยบายองค์กร